Votre assistant répond mal
Il retrouve le mauvais passage, cite une ancienne version ou répond quand la source manque.
Nous auditons vos sources, préparons vos documents et construisons la recherche qui alimentera vos outils IA. Vous obtenez une architecture documentée, des règles de gouvernance et une base évaluée sur les questions de vos équipes.
Il retrouve le mauvais passage, cite une ancienne version ou répond quand la source manque.
La même information existe dans la GED, les tickets, les fichiers partagés et les outils métier.
Les mises à jour, les droits, les coûts et la maintenance n’ont pas été traités.
Chaque étape peut être contractualisée séparément. Le devis fixe les sources, les connecteurs, les volumes, les responsabilités et les critères de recette.
Décider où investir et sur quel périmètre commencer.
Décision : un périmètre, un responsable métier et des critères de succès partagés.
Construire la chaîne qui transforme vos sources en contexte utile.
Décision : les bonnes sources sont retrouvées par les bons utilisateurs.
Vérifier la fiabilité et organiser l’exploitation.
Décision : les seuils convenus sont atteints, ou les limites sont explicitées.
L’exploitation récurrente, les licences, les appels aux modèles et le développement d’un agent métier sont chiffrés distinctement. Un périmètre pilote permet de tester les choix ; il ne remplace pas la gouvernance du patrimoine complet.
Un téraoctet de fichiers ne se convertit pas directement en tokens. La recherche sélectionne les éléments utiles à une question ; les règles d’accès s’appliquent avant leur transmission au modèle.
GED, fichiers, tickets, exports métier : périmètre et droits vérifiés.
Texte, tableaux, versions, métadonnées et provenance conservés.
Mots-clés + recherche sémantique, filtres puis classement des passages.
Contexte autorisé, références consultables et abstention si nécessaire.
Cette architecture de recherche augmentée (RAG) est une option, pas une obligation. Pour une donnée chiffrée en base, une requête structurée ou un calcul contrôlé peut être préférable à une recherche de passages.
Nous testons les PDF natifs, les scans et les tableaux sur un échantillon représentatif. Les documents illisibles sont mis en quarantaine avec une cause explicite, plutôt que silencieusement ignorés.
Contrôle : taux de documents traités, erreurs d’extraction et couverture du corpus.
Chaque document reçoit un identifiant, une source, un propriétaire, une date de validité, une version et une classification. Le découpage conserve titres, pages et liens vers le document d’origine.
Contrôle : retrouver la version applicable et sa provenance.
Nous comparons mots-clés, recherche vectorielle et recherche hybride sur vos questions. Le reclassement des résultats est ajouté s’il améliore la qualité à un coût et un délai acceptables.
Contrôle : présence de la source attendue parmi les premiers résultats (Recall@k).
Nous modélisons les utilisateurs, groupes et droits documentaires. Les filtres sont appliqués à la recherche ; un simple avertissement dans le prompt ne constitue pas un contrôle d’accès.
Contrôle : tests croisés entre profils, retrait d’accès et sources interdites.
La chaîne détecte les documents nouveaux, modifiés et supprimés. Elle permet de reprendre un traitement en échec et de réindexer après un changement de schéma ou de modèle d’embedding.
Contrôle : délai de fraîcheur, suppression dans les index et absence de versions fantômes.
Nous constituons un jeu de questions avec réponses et sources attendues, validé par les métiers. Les tests couvrent aussi les documents contradictoires, les questions hors périmètre et les instructions malveillantes présentes dans les sources.
Contrôle : citations justifiées, réponses acceptées, refus utiles, latence p95 et coût par requête.
Sur 400 demandes par mois, passer de 12 à 7 minutes de recherche représente environ 33 heures libérées. Ce gain reste une hypothèse à tester ; le temps de vérification, la maintenance et les coûts du service doivent être déduits pour calculer le bénéfice net.
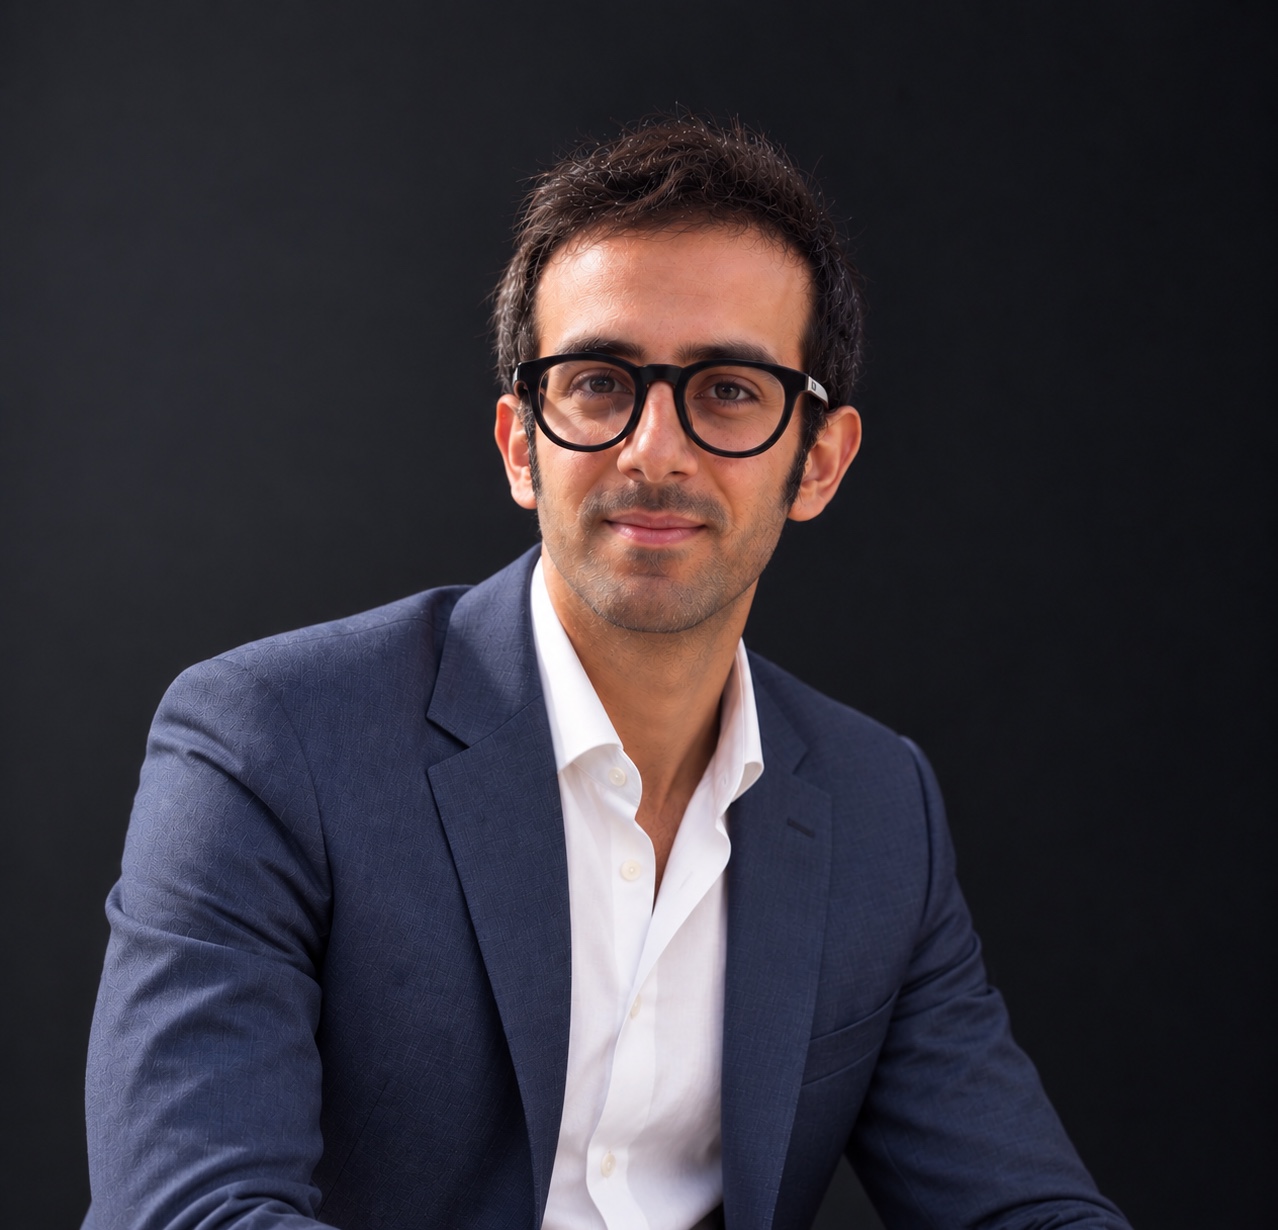
Votre référent Mintera Knowledge
Data & valorisation par l’IA · 8 ans chez Sopra Steria
Benjamin apporte huit années d’expérience chez Sopra Steria et une maîtrise des problématiques de données et de leur valorisation par l’IA. Chez Mintera, il est votre référent pour relier les besoins métier à la préparation des données et aux choix d’intégration.
Son rôle sur votre projet : challenger le périmètre, examiner les sources, définir les critères de qualité et organiser les arbitrages techniques avec vos équipes.
Solliciter Benjamin pour mon projetPrécisez vos outils, les données concernées et le résultat attendu. Nous définirons les travaux utiles et un périmètre chiffrable.